CRO et Brand Equity : un pont encore manquant dans la plupart des équipes e-commerce

Dans les équipes qui pratiquent le CRO et le branding au quotidien, personne ne s'étonne vraiment que les deux soient liés.
Un responsable growth qui a un peu d'expérience sait qu'un test gagnant sur la conversion peut coûter cher trois mois plus tard s'il a rogné sur ce qui rendait la marque désirable.
Une équipe de marque qui a déjà lancé un site sait qu'une identité qui refuse de se confronter à l'usage réel finit par produire de belles pages que personne ne convertit.
Le désaccord de fond, celui qu'on aime raconter dans les conférences, existe surtout dans la tête des commentateurs qui n'ont jamais eu à faire tourner les deux en même temps.
Sur le terrain, on rencontre cependant régulièrement un problème d'organisation.
La roadmap CRO se décide dans une réunion, la charte de marque se défend dans une autre, et les deux équipes travaillent rarement sur le même tableau de bord ni sur le même calendrier de décision. Cette séparation, qui n’a rien d'idéologique, vient simplement de la façon dont la plupart des entreprises structurent leurs équipes, avec un responsable growth qui répond d'un chiffre de conversion et un responsable marque qui répond d'une perception, sans qu'aucun des deux n'ait vraiment la charge de vérifier que l'un ne grignote pas l'autre.
Ce vide de gouvernance produit ensuite l'impression d'un conflit entre deux dynamiques qui, sur le fond, cherchent exactement la même chose : comprendre pourquoi un client choisit, hésite, revient ou renonce.
Les deux disciplines partagent pourtant beaucoup de choses, et une fois que la réflexion atteint ce niveau, on peut commencer à comprendre ce qui les sépare et ce qui les rapproche.
Les deux avancent par hypothèses qu'elles confrontent au réel plutôt que par intuition pure, les deux acceptent qu'une part de leurs paris échoue, un test qui ne gagne pas, une campagne de marque qui ne change rien à la notoriété, sans y voir un drame.
Les deux, enfin, cherchent moins à plaire qu'à comprendre ce qui fait qu'un client agit comme il agit.
Ce qui les distingue tient surtout au rythme et au coût d'une erreur.
Un test qui se trompe coûte quelques semaines de trafic mal exploité, une perte réversible et généralement mesurable avec précision dès la semaine suivante. Une décision qui abîme la perception d'une marque se corrige beaucoup plus lentement, parce qu'elle touche une confiance construite sur plusieurs années, rarement réparable par une seule décision inverse.
Cette différence de coût, et non de nature, justifie qu'on traite différemment les décisions selon ce qu'elles engagent, sans jamais avoir besoin de prétendre que l'une des deux disciplines compte plus que l'autre.
Un test A/B produit une preuve nette en deux à quatre semaines, un écart de conversion, une significativité statistique, une courbe qui monte ou qui ne monte pas. Cette preuve a une limite qu'on mentionne rarement : elle ne regarde que ce qui se passe pendant la fenêtre du test, sur les visiteurs qui arrivent pendant la fenêtre du test.
Si une variante entame, très légèrement, la confiance qu'un client accorde à la marque, cet effet ne se voit pas à J+14.
Il se voit, quand on le cherche, à J+90 ou J+180, dans un taux de retour un peu plus haut, un panier moyen un peu plus bas sur les clients qui reviennent, un NPS qui glisse de deux points sur un trimestre.
Cela tient à une conséquence directe de la façon dont l'A/B testing fonctionne statistiquement : pour obtenir une puissance suffisante sur une fenêtre courte, il faut une métrique simple et proche dans le temps, et la conversion coche cette case beaucoup mieux que la perception de marque.
Les entreprises qui ont déjà résolu ce problème n'ont pas inventé de nouvelle philosophie. Elles ont ajouté un instrument de mesure.
Dans la littérature de l'expérimentation, on parle de “guardrail metrics”, des indicateurs qui n'ont pas vocation à être optimisés mais qui doivent rester stables, quel que soit le résultat du test principal.
Ron Kohavi, qui a dirigé les équipes d'expérimentation de Microsoft puis d'Airbnb avant de coécrire l'ouvrage de référence sur le sujet, décrit ces indicateurs comme les garde-fous qui empêchent un test de gagner sur un critère en dégradant silencieusement autre chose.
Chez Airbnb, un test pensé pour augmenter les réservations reste sous surveillance sur la satisfaction déclarée des voyageurs, pour qu'un gain de conversion ne se paie pas en avis négatifs quelques semaines plus tard.
Chez Netflix, un test sur les recommandations reste sous surveillance sur la qualité de streaming, pour la même raison.
Rien n'empêche d'appliquer exactement cette logique à la marque plutôt qu'à la satisfaction ou à la qualité technique : suivre, sur les tests jugés à fort impact identitaire, un ou deux indicateurs de perception, même approximatifs, et rouvrir le dossier quatre-vingt-dix jours plus tard plutôt que de l'archiver comme un succès dès le quatorzième jour.
Booking.com illustre bien ce que ça donne quand une entreprise pousse la logique du test à son maximum sans avoir, au départ, ce genre de garde-fou.
Le groupe s'est construit une culture d'expérimentation particulièrement poussée, documentée notamment par une étude de cas de Harvard Business School : des milliers de tests en simultané, une décentralisation qui permet à n'importe quelle équipe de lancer un test sans validation hiérarchique préalable, et une anecdote souvent citée dans le secteur, celle du premier dirigeant américain du groupe qui avait proposé un nouveau logo à son arrivée et s'était vu répondre qu'on allait d'abord vérifier ça par un test, sans exception possible même pour un choix aussi identitaire.
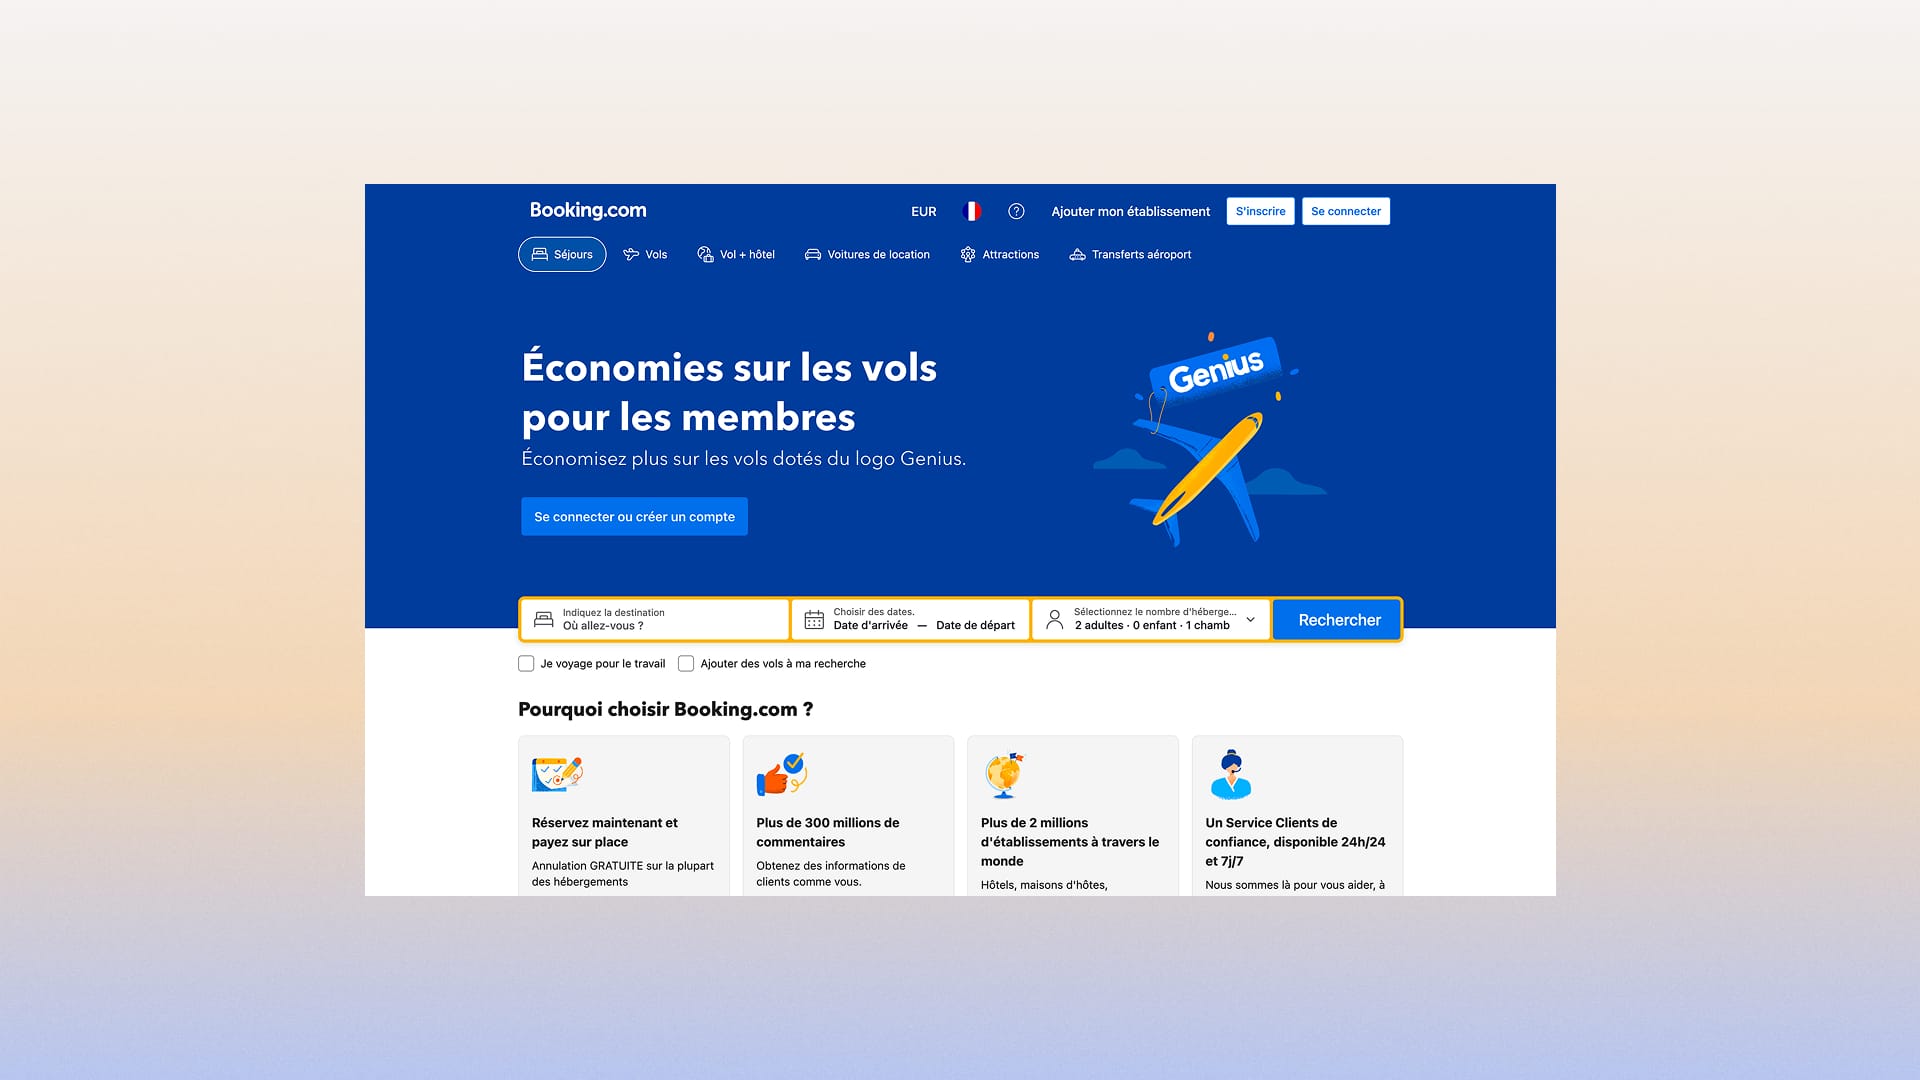
Cette discipline a produit des résultats commerciaux considérables, mais aussi, pendant plusieurs années, une accumulation de bandeaux d'urgence, de messages de rareté et de popups de réassurance, chacun validé isolément par un test gagnant, jusqu'à ce que l'expérience globale soit régulièrement pointée du doigt pour son caractère anxiogène.
L'autorité britannique de la concurrence a fini par ouvrir une enquête sur les pratiques commerciales du secteur de la réservation hôtelière en ligne, engageant en 2018 une action visant à mettre fin aux tactiques de vente jugées trompeuses.
Lire aussi pour aller plus loin :
 Robin Marzin
Le groupe a depuis fait évoluer une partie de son interface vers plus de sobriété, un ajustement qui confirme, a posteriori, exactement le point que les guardrail metrics cherchent à traiter en amont : un test peut gagner très proprement sur la conversion tout en abîmant, sur une durée plus longue, quelque chose que personne n'avait mis sous surveillance.
Ce qui rend le cas intéressant, au-delà de l'anecdote, c'est que Booking.com n'a jamais renoncé à sa culture de test pour autant.
La même étude documente comment l'équipe traite ses échecs : plutôt que d'archiver un test raté, elle cherche à comprendre pourquoi, en s'appuyant sur des entretiens qualitatifs. Un test qui affichait la force du signal WiFi d'un hôtel n'a d'abord rien changé à la conversion, jusqu'à ce que l'équipe découvre, en interrogeant des voyageurs, que ce n'était pas la vitesse du WiFi qui comptait mais ce qu'elle permettait de faire concrètement, regarder une série sans coupure, envoyer des mails sans attendre.
Le test suivant, qui parlait de ce que le WiFi rendait possible plutôt que de sa performance brute, a fonctionné.
Cette méthode, tester, observer un échec, aller chercher pourquoi plutôt que de passer au test suivant, est exactement le réflexe qui manque le plus souvent quand un test touche à la marque : la donnée de premier niveau ne suffit jamais à elle seule, elle doit être complétée par une lecture qualitative de ce qu'elle recouvre réellement.
Glossier permet de regarder le même problème depuis l'autre bout.
La marque a construit des fiches produit minimalistes, sans compte à rebours ni popup de dernière minute, où chaque élément reste immédiatement reconnaissable. Dans un secteur beauté où le taux de conversion moyen en France se situe entre 2,5% et 3,5%, elle performe structurellement au-dessus de cette moyenne sans recourir aux mécaniques d'urgence habituelles, pour une raison de séquence plus que d'intensité : une grande partie de ses client·es a déjà pris sa décision d'achat avant même d'arriver sur la fiche produit, grâce à un travail de communauté et de contenu mené en amont.
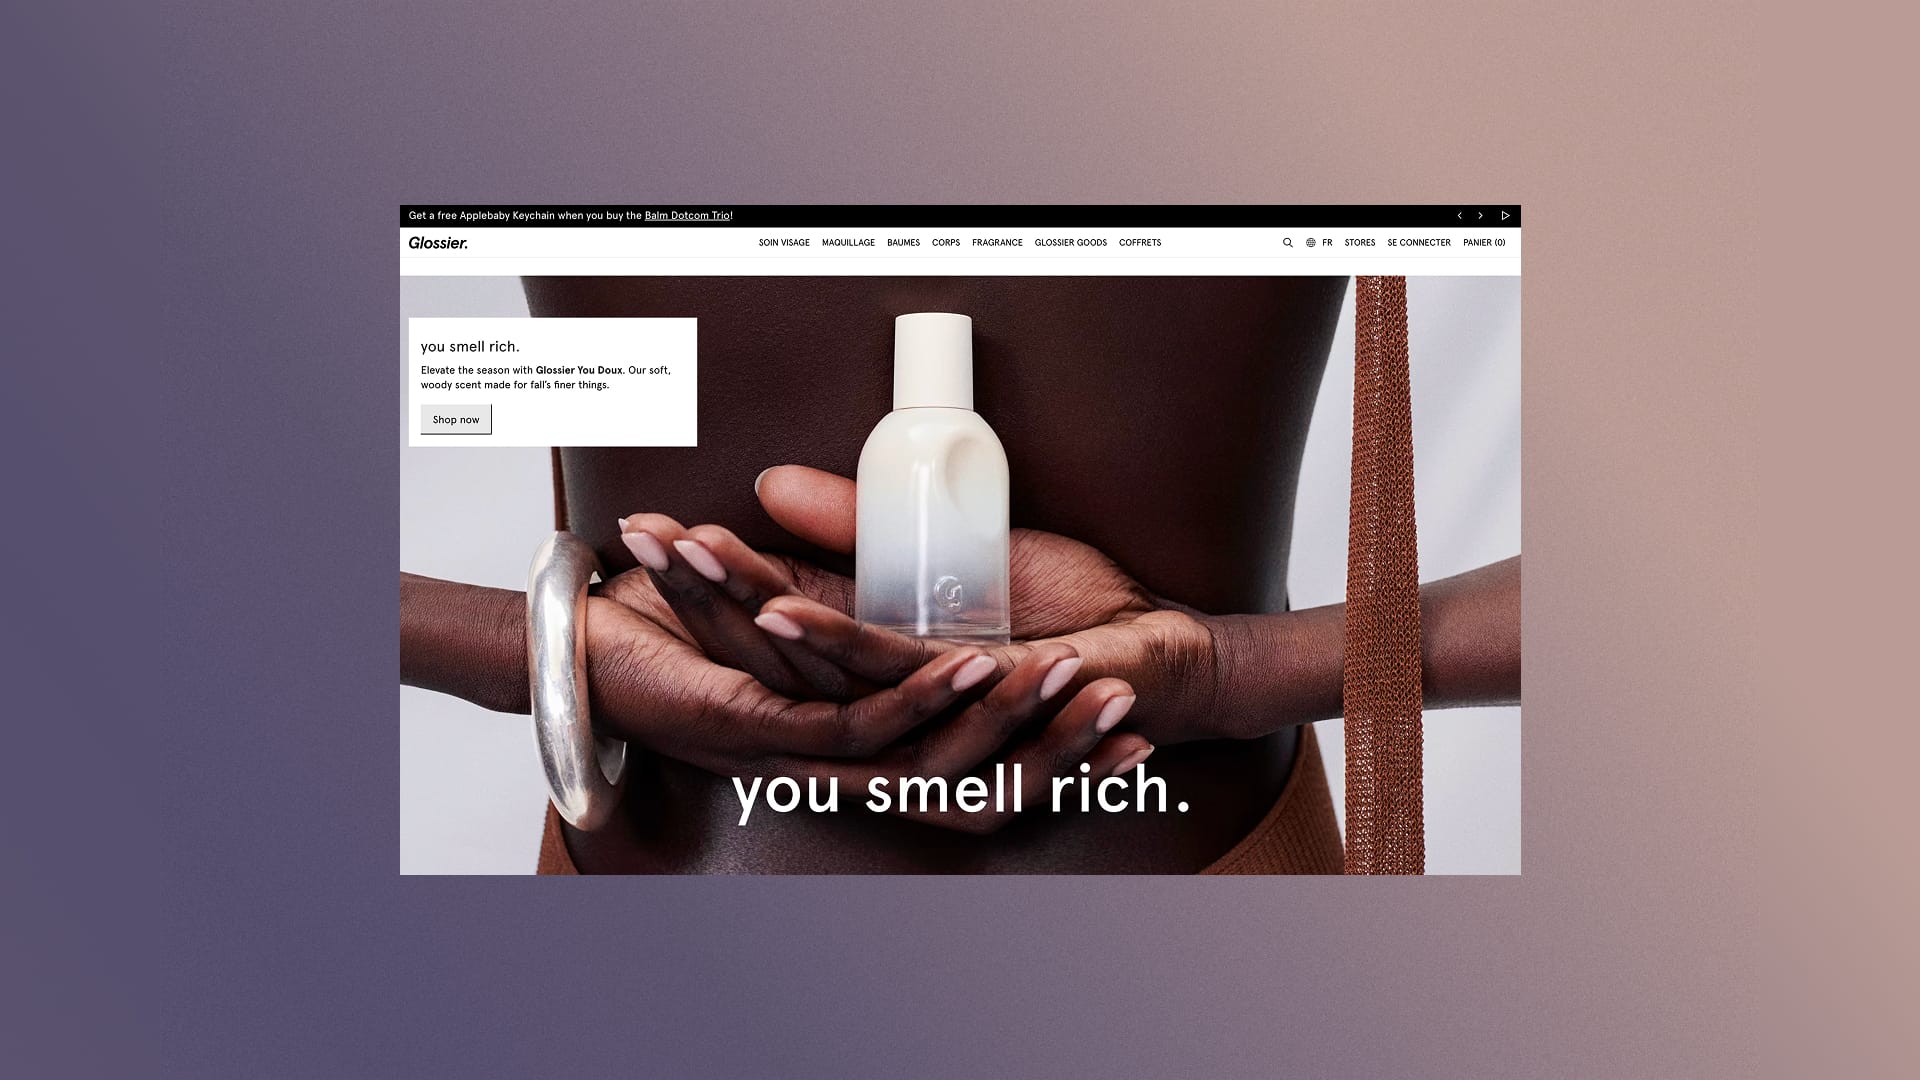
Emily Weiss, sa fondatrice, décrit cette bascule dans une interview accordée à FrenchWeb, où elle explique que la décision d'achat se construit dans la communauté plutôt que sur la page produit elle-même. Le CRO y retrouve un rôle précis, celui de retirer les frictions résiduelles sans avoir à compenser une conviction qui s'est déjà formée ailleurs.
Quand l'équipe a voulu tester des éléments plus directement orientés conversion, elle a choisi de le faire sur des pages isolées, en dehors du site principal, ce qui revient exactement au même principe que le garde-fou décrit plus haut, formulé autrement : séparer l'espace où l'on peut se tromper sans conséquence de l'espace où une erreur coûterait cher à long terme.
Ce que Booking.com et Glossier montrent, chacun à leur manière, c'est qu'aucune des deux disciplines n'a besoin de céder du terrain à l'autre pour qu'elles avancent ensemble.
Ce qui fait la différence, c'est le moment où on choisit de regarder ce qu'un test produit au-delà de sa fenêtre de mesure habituelle, et l'endroit où on décide de placer le curseur entre ce qui peut se tester librement et ce qui mérite d'être surveillé de plus près.
Concrètement, pour une équipe e-commerce qui voudrait appliquer ce principe sans réorganiser toute sa gouvernance, trois choses suffisent à démarrer :
- Nommer, avant de lancer un programme de tests, les deux ou trois éléments d'identité qu'on refuse de voir se dégrader même si un test gagne dessus.
- Ajouter, sur les tests qui touchent à ces éléments, un ou deux indicateurs de perception suivis sur plusieurs mois plutôt que sur deux semaines.
- Prévoir un moment fixe, un trimestre plus tard par exemple, pour rouvrir ces tests-là et vérifier qu'ils tiennent toujours la route une fois sortis de leur fenêtre statistique.
Le manque tient souvent à la manière dont est organisé le management et la chaîne de prise de décision, à l'organisation et à la communication interne : décider qui lit les rapports, à quelle fréquence, et avec quelle autorité.
C'est une question de vision et de gouvernance avant d'être une question de méthode.
Elle explique pourquoi si peu d'entreprises y arrivent, moins par manque d'outils que par réticence à admettre qu'aucune des deux équipes ne peut, seule, garantir que l'autre progresse au même rythme qu'elle.